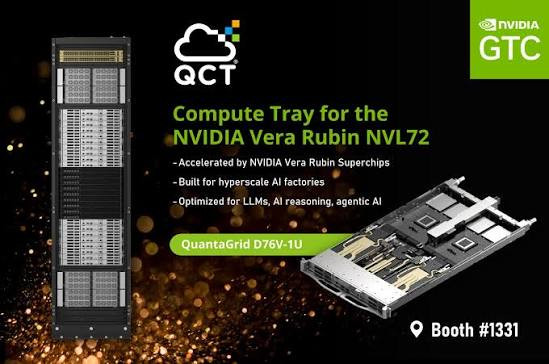
NVIDIA ngày 24/8/2026 công bố dữ liệu hiệu năng mới cho Vera Rubin NVL72 trên workload agentic coding. Theo phép đo nội bộ dựa trên SemiAnalysis AgentX, hệ thống đạt throughput trên mỗi megawatt cao tới 30 lần so với GB300 NVL72 trong trường hợp DeepSeek V4 Pro, đồng thời NVIDIA nêu mức chi phí trên một triệu token có thể thấp hơn tới 35 lần. Các số liệu đang chờ SemiAnalysis review nên cần được xem là dữ liệu do NVIDIA công bố, không phải kết quả độc lập đã hoàn tất đánh giá bên ngoài.
AI Agent Tiêu Thụ Nhiều Token Hơn Chat Thông Thường
NVIDIA dẫn dữ liệu OpenRouter cho thấy agentic workload có thể tiêu thụ lượng token lớn hơn đáng kể so với một lượt chat đơn giản. Lý do là agent liên tục gọi dữ liệu, tool, agent phụ rồi đưa kết quả cũ trở lại context cho bước sau. Khi chuỗi công việc dài, hạ tầng phải xử lý cả prefill và decode liên tục. Lúc đó, chỉ đo hiệu năng GPU riêng lẻ chưa phản ánh đầy đủ economics. NVIDIA vì vậy tập trung vào throughput per megawatt và cost per million tokens, hai chỉ số liên kết khả năng xử lý với giới hạn điện của data center.
Throughput Trên Mỗi Megawatt Trở Thành Chỉ Số Quan Trọng
Data center không thể tăng điện vô hạn. Khi tổng power budget bị giới hạn, hệ thống tạo được nhiều token hơn trên cùng megawatt sẽ có khả năng phục vụ nhiều workload hơn. Theo NVIDIA, Vera Rubin NVL72 đạt mức throughput mỗi MW cao tới 30 lần so với GB300 NVL72 trên phép đo DeepSeek V4 Pro được công bố.
DSX MaxLPS còn được hãng mô tả có thể quản lý power trên GPU, rack và workload để đưa thêm tới 40% GPU vào cùng ngân sách megawatt trong một số điều kiện. Con số này không đồng nghĩa mọi data center tự động tăng số GPU tương ứng. Cooling, rack, network và giới hạn facility vẫn ảnh hưởng.
Disaggregated Serving Tách Prefill Và Decode
Vera Rubin hỗ trợ mô hình serving tách context processing khỏi response generation. Hai giai đoạn có thể scale độc lập để tài nguyên phù hợp hơn với workload. Rate matching đồng bộ tốc độ giữa GPU làm prefill và GPU làm decode. Nếu hai phần mất cân đối, một nhóm accelerator có thể phải chờ nhóm còn lại, làm giảm utilization. Đây cũng là lý do Groq 3 LPX được NVIDIA đặt bên cạnh Vera Rubin: phần cứng khác nhau có thể tập trung vào những giai đoạn khác nhau của inference.
KV Cache Được Phân Phối Và Định Tuyến Theo Context
Agent dài ngày càng phụ thuộc KV cache vì context đã xử lý có thể rất lớn. Vera Rubin hỗ trợ distributed KV caching, offload context ít hoạt động sang host hoặc storage và KV-aware routing để request được đưa tới GPU đang giữ dữ liệu liên quan. Mục tiêu là giảm việc tính lại những context đã có. Với conversation hoặc agent kéo dài, đây là yếu tố có thể ảnh hưởng mạnh tới cost. Large-scale expert parallelism cho model mixture-of-experts cũng tận dụng scale-up domain của NVL72 để phân phối expert qua nhiều GPU.

NVFP4 Giảm Dung Lượng Model Trong Bộ Nhớ
NVIDIA mô tả NVFP4 là định dạng 4-bit giúp giảm footprint của trọng số và tăng throughput mà vẫn giữ chất lượng đầu ra trong những workload được hỗ trợ.
Việc giảm precision không phải lúc nào cũng phù hợp cho mọi model. Nhà cung cấp cần benchmark accuracy và quality trước khi đưa vào production. Vera Rubin còn dùng Tensor Core thế hệ mới và Transformer Engine để tăng tốc cả prefill lẫn decode.
NVLink 6 Tăng Kết Nối Giữa GPU
NVL72 cần giao tiếp GPU-GPU tốc độ cao cho expert parallelism và KV cache phân phối. NVIDIA cho biết NVLink thế hệ 6 cung cấp packet rate cao hơn và latency thấp hơn các lựa chọn Ethernet phổ thông trong so sánh của hãng.
Toàn bộ Vera Rubin là kiến trúc bảy chip gồm Rubin GPU, Vera CPU, Groq 3 LPU, NVLink 6 Switch, BlueField-4 DPU, Spectrum-6 SPX và ConnectX-9 SuperNIC. Điều này cho thấy hiệu năng data center hiện đại phụ thuộc vào mức độ phối hợp giữa compute, network và software nhiều hơn trước.
Người Dùng PC Có Cần Quan Tâm?
Vera Rubin NVL72 không phải sản phẩm dành cho desktop. Tuy nhiên, cách NVIDIA tối ưu quantization, caching và serving có thể dần ảnh hưởng tới software stack mà developer sử dụng trên workstation hoặc cloud.
Người chạy AI local vẫn nên tập trung VRAM, RAM, SSD và framework. GPU desktop có yêu cầu khác hoàn toàn rack NVL72. Hoàng Long Computer cung cấp workstation, GPU, RAM và SSD chính hãng cho AI local, lập trình và đồ họa.

Vera Rubin NVL72 được NVIDIA định vị quanh bài toán hiệu suất trên mỗi watt và chi phí token, hai yếu tố ngày càng quan trọng khi agent tiêu thụ context dài. Dữ liệu công bố cho thấy mức tăng rất lớn so với GB300, nhưng kết quả vẫn cần được đọc đúng điều kiện benchmark và chờ review bên ngoài. Điểm đáng quan tâm hơn con số quảng bá là kiến trúc tách prefill, decode, KV cache và networking thành những lớp được tối ưu cùng nhau.



 Website:
 Email:
 Bảo hành:
 Cơ sở 1: