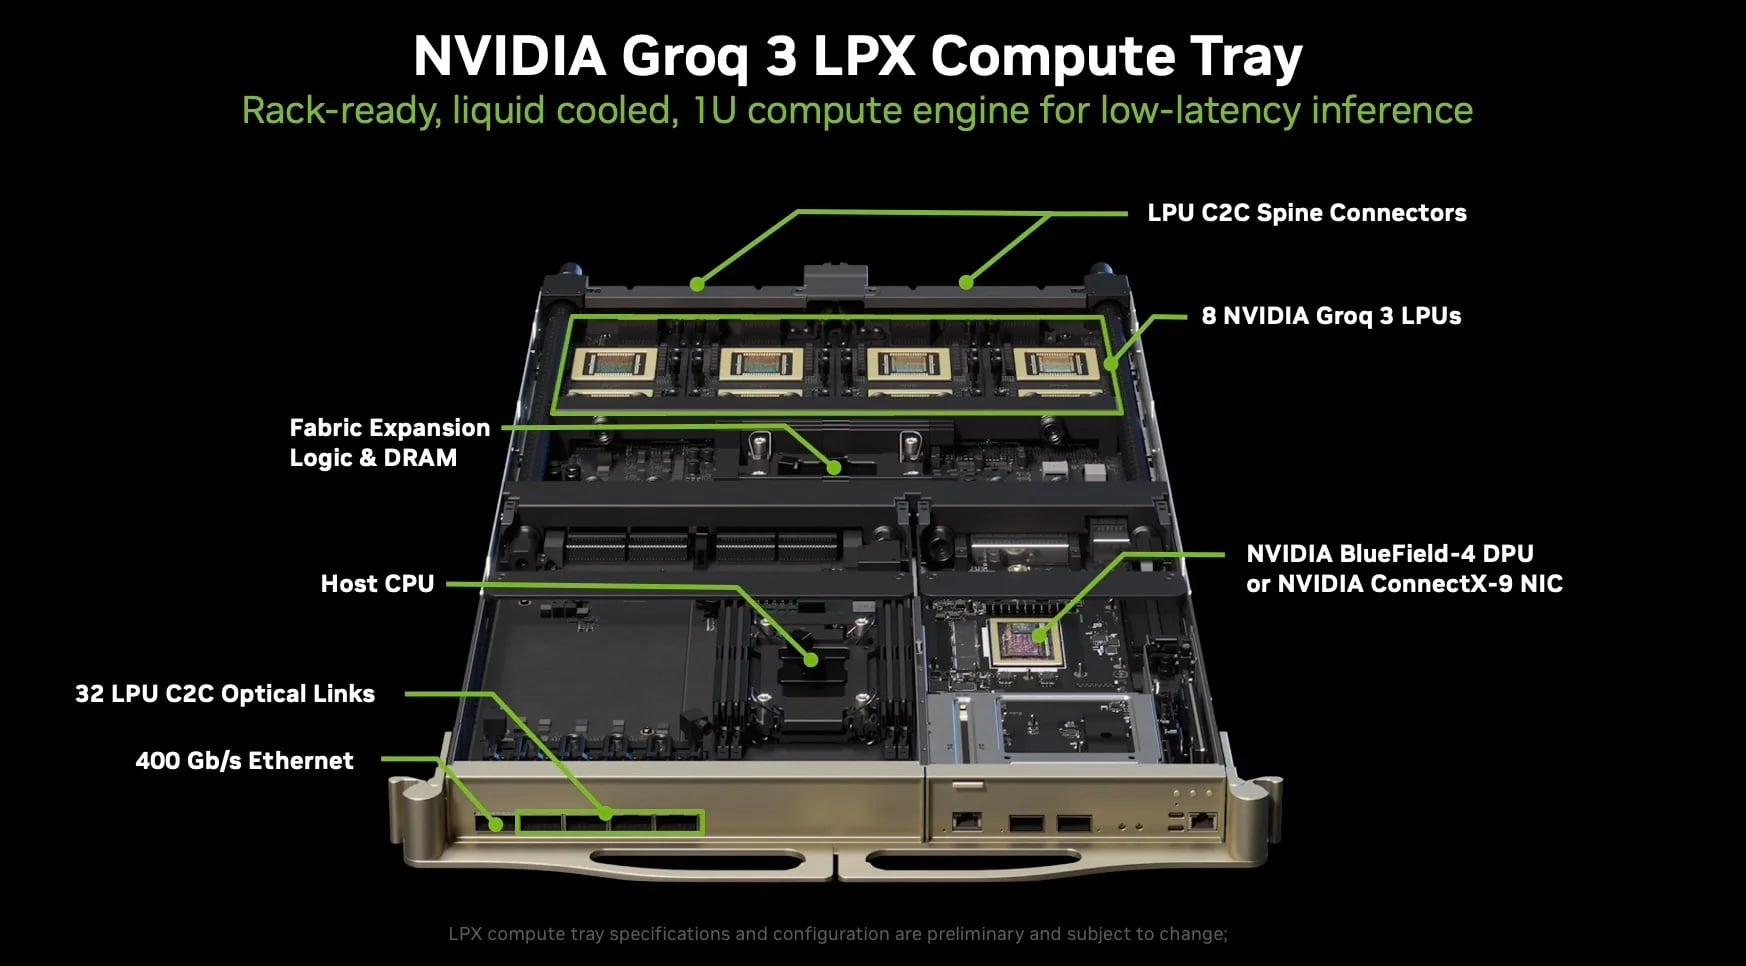
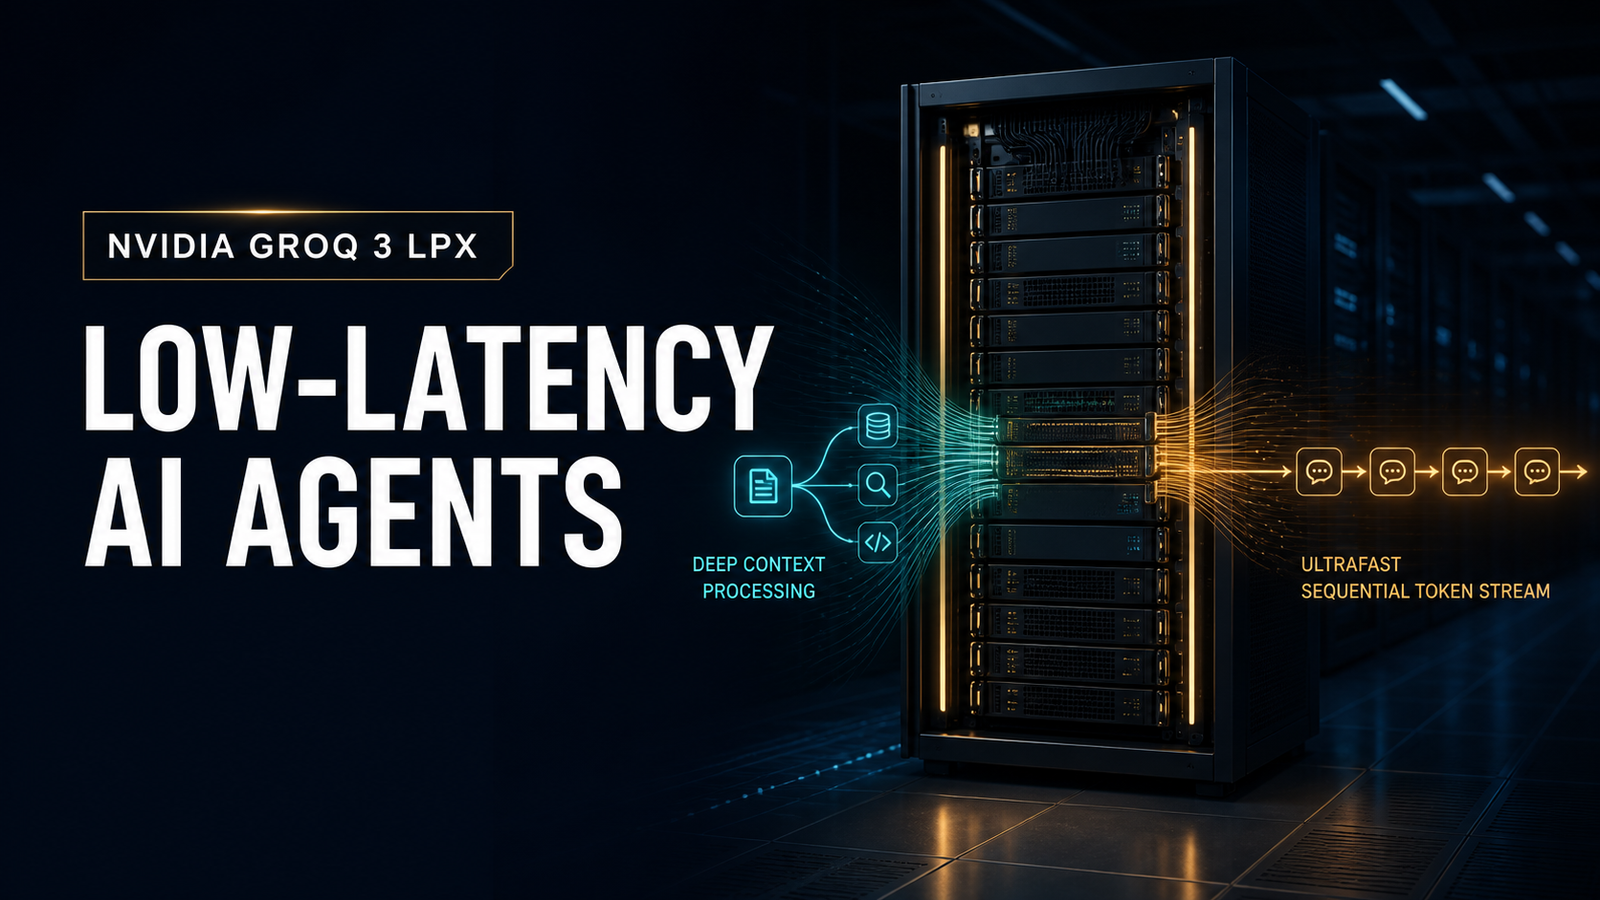
NVIDIA ngày 24/8/2026 công bố Groq 3 LPX đã bước vào sản xuất và được thiết kế để hoạt động cùng Vera Rubin NVL72 trong các AI factory. Mục tiêu của nền tảng là xử lý bài toán decode latency khi AI agent liên tục reasoning, gọi tool và tạo token qua nhiều bước. NVIDIA cũng cho biết Nebius là đơn vị đầu tiên công bố kế hoạch tích hợp Groq 3 LPX vào Token Factory của hãng.
Agentic AI Tạo Áp Lực Khác Chatbot Truyền Thống
Một chatbot đơn giản có thể nhận prompt rồi trả lời một lần. AI agent phức tạp hơn vì nó có thể tìm dữ liệu, chạy code, sử dụng tool, gọi agent phụ và tiếp tục reasoning trước khi hoàn thành nhiệm vụ.
Mỗi bước sinh thêm token và kéo dài context. Chỉ một lượng latency nhỏ trong quá trình decode cũng có thể cộng dồn thành thời gian đáng kể sau hàng chục lượt tool call. Groq 3 LPX được NVIDIA thiết kế để tập trung vào giai đoạn tạo token có độ nhạy latency cao. Trong kiến trúc kết hợp, Rubin GPU xử lý phần context quy mô lớn, còn LPX tăng tốc decode.
GPU Và LPU Được Thiết Kế Làm Việc Chung
NVIDIA mô tả Groq 3 LPX không phải accelerator hoạt động tách khỏi Vera Rubin. Rubin GPU và LPU cùng tham gia tính toán qua các layer của model, với mục tiêu cân bằng throughput và độ phản hồi.
Một deployment dạng rack có thể chứa 256 LP30 accelerator liên kết trực tiếp, tạo engine inference hướng tới workload agent. Ý tưởng nằm ở việc không buộc một loại chip phải tối ưu cho mọi giai đoạn. Context processing và token generation có đặc tính khác nhau, nên NVIDIA tách workload sang phần cứng phù hợp hơn.
Benchmark Gemma 4 31B Được NVIDIA Công Bố Ở 3.400 Token/Giây
Trong thông báo ngày 24/8, NVIDIA cho biết một benchmark Artificial Analysis chạy Gemma 4 31B với context 100.000 token đạt 3.400 output token mỗi giây trên nền tảng Groq 3 LPX. Hãng mô tả kết quả này cao gấp bốn lần nền tảng thay thế gần đó trong phép đo của mình.
Đây là dữ liệu do NVIDIA công bố nên cần được đọc trong đúng điều kiện benchmark, không nên chuyển thành kết luận rằng mọi model hoặc workload đều tăng cùng tỷ lệ. Context length, batch size, quantization, model architecture và yêu cầu latency đều có thể làm kết quả thay đổi.
Nebius Và SpaceXAI Xuất Hiện Trong Hệ Sinh Thái Vera Rubin
Nebius dự kiến đưa Groq 3 LPX vào hạ tầng Token Factory để phục vụ agent tương tác và coding system. CoreWeave đang triển khai Spectrum-X Multiplane để kết nối rack Vera Rubin.
SpaceXAI cũng được NVIDIA công bố có kế hoạch sử dụng Vera CPU cho những tác vụ CPU-heavy như orchestration, tool use, code execution, data processing và simulation. Các trường hợp này cho thấy cuộc đua AI infrastructure không còn chỉ xoay quanh GPU. CPU, LPU, networking và software stack cùng tham gia quyết định chi phí và thời gian phản hồi.
Spectrum-X Multiplane Hướng Tới Cụm Rất Lớn
NVIDIA cho biết Spectrum-X Multiplane chia kết nối server thành nhiều plane song song. Thiết kế hướng tới khả năng scale tới 512.000 GPU mà không phải thêm tầng mạng thứ ba.
Trong topology tám plane, nếu một plane gặp lỗi, NVIDIA cho biết hệ thống vẫn giữ khoảng 90% băng thông tổng và phần cứng có thể phục hồi nhanh hơn giải pháp cân bằng nhiều plane bằng phần mềm trong phép đo của hãng. Đây là bài toán đặc biệt quan trọng với inference quy mô lớn vì một bottleneck network có thể làm accelerator chờ dữ liệu dù compute vẫn còn khả năng xử lý.
Điều Này Có Ý Nghĩa Gì Với Developer?
Developer gọi model qua API không cần mua hạ tầng Groq 3 LPX. Tác động xuất hiện gián tiếp nếu nhà cung cấp cloud dùng kiến trúc mới để giảm latency hoặc cost.
Với AI agent, nên đo thời gian hoàn thành toàn bộ task thay vì chỉ token/giây. Một hệ thống sinh token rất nhanh nhưng tool chậm hoặc orchestration kém vẫn có thể tạo trải nghiệm ì ạch. Các chỉ số nên xem cùng nhau gồm time-to-first-token, decode speed, tool latency, tỷ lệ hoàn thành và chi phí trên task.
PC Phát Triển Agent Không Cần Cấu Hình Data Center
Một PC dùng API cloud có thể ưu tiên CPU nhiều nhân, RAM 32 GB và SSD NVMe cho IDE, Docker, database và service local. GPU rời chỉ cần khi developer còn chạy model tại máy. Nếu làm local inference, VRAM trở thành yếu tố đáng quan tâm hơn CPU đơn thuần. Model, quantization và context phải được xác định trước khi chọn GPU.
Hoàng Long Computer cung cấp workstation, PC lập trình, GPU, RAM và SSD chính hãng, hỗ trợ cấu hình cho AI cloud hoặc AI local.
NVIDIA Groq 3 LPX cho thấy inference của AI agent đang được tách thành nhiều giai đoạn để tối ưu riêng. Rubin GPU xử lý context, LPX hướng tới decode latency, còn Spectrum-X xử lý lưu lượng giữa các rack. Thay vì một chip làm mọi thứ, NVIDIA đang xây AI factory như một hệ thống nhiều thành phần được thiết kế cùng nhau. Hiệu quả thực tế với từng model vẫn cần benchmark độc lập, nhưng hướng kiến trúc này phản ánh rõ nhu cầu token đang tăng rất nhanh.



 Website:
 Email:
 Bảo hành:
 Cơ sở 1: